
作为RAG领域的经典论文,这篇论文核心讨论了RAG模型,文中提到了RAG-序列模型和RAG-token模型以及其核心原理。同时实验对比了RAG和现有的BERT等在NLP多个任务中的表现,表明了RAG模型的可行性和优越性。接下来,将针对论文核心部分做个人学习总结。
前置了解
- 大模型虽然取得部分成效,但是针对特定领域,效果还是不如特定领域的模型,目前在知识密集型任务中预训练语言模型如何决策以及如何高效及时更新知识都是还需持续研究的。
- 目前特定的领域模型训练成本很高,而且无法保证训练数据的真实性和时效性,想要获得效果好的模型需要不断微调,耗费很多人力物力财力
原理解析
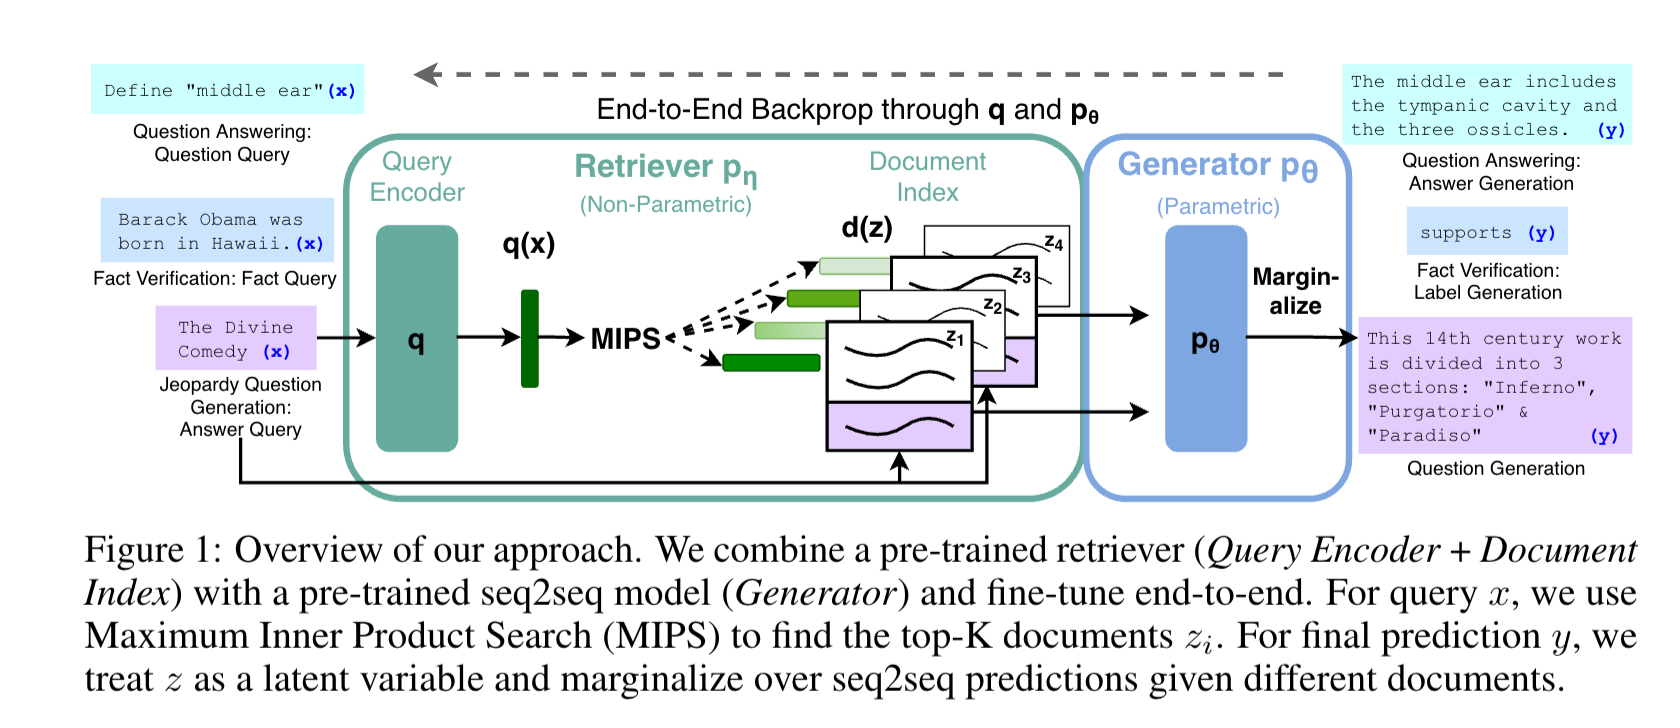
- RAG的核心分为两部分,检索和生成
- 检索器会根据$p_\eta(z|x)$找出和输入序列$x$最相关的$top-k$个文本段落$z$
- 生成器会根据$p_\theta(y_i|x,z,y_{1:i-1})$,也就是根据前面输入序列$x$,文档$z$,以及前面生成的$i-1$个序列进行生成
RAG-Sequence模型
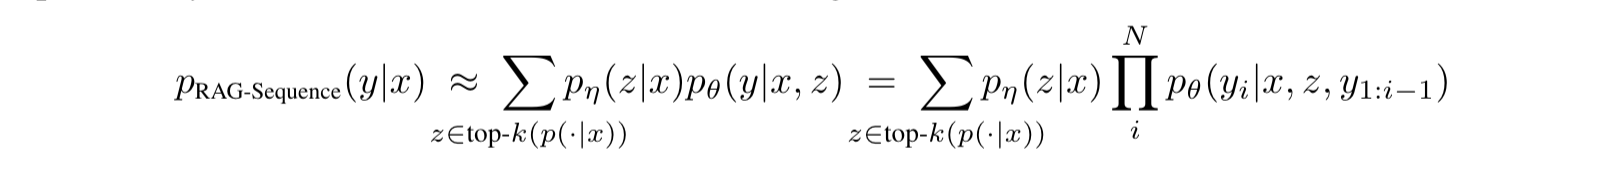
- 对于给定的输入序列$x$,首先会使用预训练的检索器$p_\eta(z|x)$从大规模文档集合中检索中前K个相关文档
- 然后输入序列x会和相关文档被组合处理,作为生成器的输入
- 生成器$p_\theta(y_i|x,z,y_{1:i-1})$会先生成一个完整序列,序列中包含$N$个$token$,序列中的$token$会考虑到前文已经生成的$token$,最终序列所有的$token$生成概率乘积下来,同时基于输入$x$和检索到的文档$z$,即$p_\theta(y_1|x,z)$,这样就是使用同一个文档来生成序列的概率
- 为了考虑到$top-k$文档对序列的贡献,所以这里会有一个求和操作,通过加权融合不同文档的概率,找出最合适的序列
RAG-Token模型
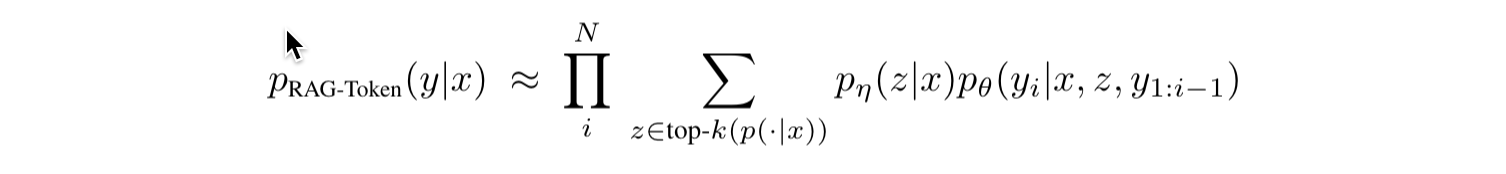
- 同样先对输入的序列x利用检索器$p_\eta(z|x)$检索出前K个相关文档,输入的x也会作为后续生成操作的基础信息
- 和序列模型不同的是,$token$模型是逐个$token$生成的,在计算每个$token$的时候,会计算当前$token$在输入$x$,文档$z$以及上下文$y_{1:i-1}$的概率$p_\theta(y_i|x,z,y_{1:i-1})$,有了这个之后会和$top-k$文档进行相乘,然后加权融合考虑多个文档对$token$的贡献
- 基于以上分析,这里我是这么理解的,首先是预生成器里面本身就存在一个词表,里面存储着成千上万个$token$,这里对应数学公式的$y$,然后检索器会给每个$token-y$一个基于当前输入的概率,最终我们通过数学公式计算出概率最大的$token$,作为最新的输出$token$,然后在生成后续的$token$的时候,会重复上述过程,同时考虑到上下文,生成后续的$token$。最后我们会得到若个完整的序列,我们计算每个序列逐个token位置概率乘积,找到最大的那个就是我们最终的回答
检索器:DPR
- 检索组件$p_\eta(z|x)$是以DPR为基础,DPR采用双编码器架构,$p_\eta(z|x)$与$exp((d_z)^Tq(x))$成正比
- 其中$d_z$是基于$BERT_{BASE}$的文档编码器$(BERT_d(z))$生成文档$z$的密集表示,$q(x)$同样是是基于$BERT_{BASE}$的查询编码器生成的查询$x$的表示
- 上述公式表示通过计算文档表示向量$d(z)$和查询表示向量$q(x)$的内积,并对结果取指数,进而可以衡量文档和查询之间的相关性,最终得到文档的检索概率
- $Top-k$文档的检索,由于我们已经将文档转为向量集合,同时有输入$x$,就可以通过$MIPS$(最大内积搜索)检索出最相关的$k$个文档作为后续生成器的输入
生成器:BART
- 生成器组件$p_\theta(y_i|x,z,y_{1:i-1})$可以使用任何编码器-解码器进行建模,论文里面用的BART-Large,这是一个具有4亿参数的预训练的序列到序列Transformer模型
综合比较
- RAG-序列模型:生成连贯性好,更注重从宏观上把握文档的信息,计算相对高效。适用于文本摘要,故事生成等场景
- RAG-Token模型:信息利用更加灵活,逐个token生成,每个token生成都会综合考虑到多个文档,动态从多个文档中找到最适合的信息,表述更加精确。实验表明在问答方面效果优于序列模型。适用于需要精确表述和对细节信息有较高要求的场景